ANLEITUNG
Gesang in Audacity entfernen
Audacity kann einen mittig liegenden Lead-Gesang aus einer Stereospur ziehen, und es ist kostenlos und offline. Es nimmt aber auch Kick und Bass mit, und bei jeder Mischung, in der der Gesang Stereohall trägt — also bei den meisten kommerziellen Pop-Produktionen — funktioniert es kaum. Hier steht, wie es geht und wie du vorher erkennst, ob sich der Versuch lohnt.
Die kurze Antwort
Öffne die Stereodatei, markiere die ganze Spur, dann Effekt → Vocal Reduction and Isolation, setze Action auf Remove Vocals, und exportiere. Audacity 3.2 hat das Effekt-Menü in Untermenüs umgebaut, in aktuellen Versionen schaust du also unter Effekt → Spezial; in 2.x sitzt er direkt im Effekt-Menü.
Das ist die ganze Prozedur. Der Rest dieser Seite handelt von dem Teil, den niemand erwähnt: was der Effekt tatsächlich tut, und warum das Instrumental, das er zurückgibt, hohl klingt.
Methode 1: der eingebaute Effekt
- Importiere eine Stereodatei.
File → Import → Audio, oder zieh sie ins Fenster. Sie muss stereo sein — siehe die Mono-Anmerkung unten. - Markiere alles.
Ctrl+A(Cmd+Aauf macOS). - Öffne den Effekt. Vocal Reduction and Isolation, aus dem Menü
Effect— im UntermenüSpecialab 3.2, in 2.x direkt im Menü. - Setze Action auf »Remove Vocals«. Derselbe Dialog kann stattdessen den Gesang isolieren, was eine nützliche Art ist, genau zu hören, was abgezogen wird.
- Lass Strength für den ersten Durchgang auf 1.0. Höher löscht mehr Stimme und mehr von allem anderen mit ihr aus.
- Setze Low Cut for Vocals auf etwa 120 Hz. Alles darunter bleibt unangetastet. Dieser eine Regler ist es, der die Basslinie am Leben hält.
- Setze High Cut for Vocals auf etwa 9 kHz. Alles darüber bleibt unangetastet, was Becken und Luft erhält.
- Vorhören, dann anwenden. Exportieren mit
File → Export Audio.
Die meisten Anleitungen sagen dir, du sollst mit den Voreinstellungen auf OK drücken. Low Cut und High Cut definieren das Band, innerhalb dessen der Effekt auslöschen darf. Dieses Band auf ungefähr den Bereich zu verengen, in dem eine Stimme lebt, ist der Unterschied zwischen einem brauchbaren Playback und einem dünnen, phasigen Durcheinander.
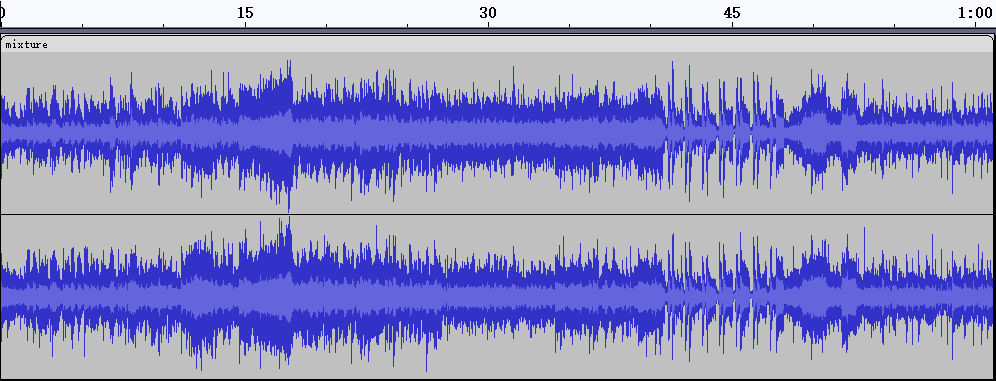
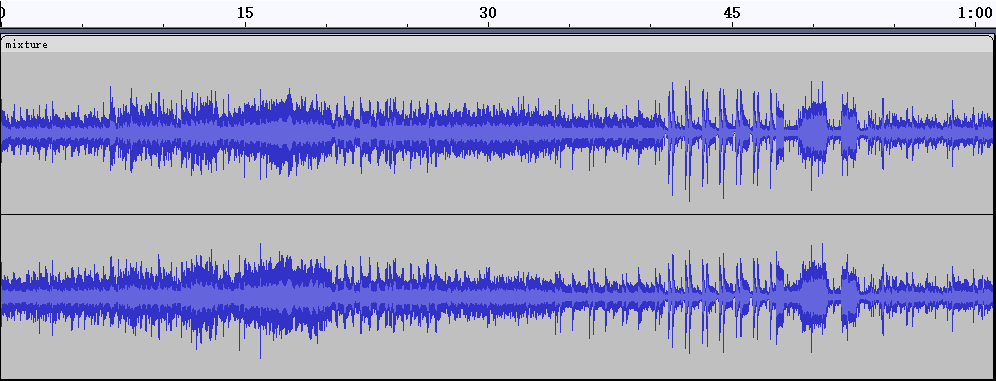
Methode 2: die manuelle Version, damit du den Mechanismus siehst
Der Effekt ist eine bequeme Hülle um vier Schritte, die du von Hand machen kannst. Es einmal manuell zu tun macht die Grenzen offensichtlich.
- Teile die Stereospur.
Tracks → Mix → Split Stereo Track. Du hast jetzt zwei unabhängige Monospuren. - Invertiere eine davon. Markiere die untere (rechte) Spur, dann wende Invertierenan, aus demselben
EffectMenü. - Setze beide auf Mitte. Stelle den Panorama-Regler jeder Spur in die Mitte.
- Spiel es ab. Alles, was in beiden Kanälen identisch ist, summiert sich jetzt zu Stille.
- Rendern.
Tracks → Mix → Mix and Render.
Keine Frequenzwächter, kein Strength-Regler — nur Subtraktion. Was du hörst, ist der rohe Effekt, und er ist meist schlechter als Methode 1, was genau der Punkt ist.
Warum das Instrumental sein Fundament verliert
Phasenauslöschung entfernt alles, was in beiden Kanälen identisch ist. Sie weiß nicht, was eine Stimme ist. In einer konventionellen Mischung ist der Lead-Gesang nicht das Einzige, das genau mittig sitzt:
| Element | Typische Platzierung | Überlebt die Auslöschung? |
|---|---|---|
| Lead-Gesang | Mitte | Nein — das beabsichtigte Ziel |
| Bassdrum | Mitte | Nein |
| Bass | Mitte, unterhalb von ~120 Hz oft absichtlich mono | Nein |
| Snare | Mitte | Nein |
| Gitarren, Keys, Backing-Gesang | Breit verteilt | Ja |
| Stereo-Hallfahnen | Per Definition breit | Ja — auch die des Gesangs |
»Die Mitte entfernen« entfernt also das rhythmische und tieffrequente Rückgrat zusammen mit der Stimme. Bass wird unterhalb von etwa 120 Hz häufig absichtlich auf Mono summiert, damit die Wiedergabe auf Vinyl und Clubanlagen stabil bleibt, was ihn zum zuverlässigsten Opfer macht. Genau das verteidigt Low Cut.
Die andere Hälfte des Problems ist der Hall. Die trockene Stimme löscht sich aus, ihre Stereofahne nicht. Das Ergebnis ist ein wiedererkennbares Artefakt: ein geisterhafter Gesangshall ohne Stimme darunter, der über dem Playback schwebt.
Wann es überhaupt nicht funktioniert
Die Datei ist mono
Es gibt nichts, wogegen subtrahiert werden könnte. Audacity zeichnet eine Wellenform-Spur für eine Monospur und zwei für eine Stereospur — der schnellste Weg, das zu prüfen, bevor du Zeit verschwendest.
Der Gesang ist nicht mittig
Manche Produktionen schieben den Lead leicht aus der Mitte oder doppeln ihn hart links und rechts. Die Auslöschung lässt den Gesang dann weitgehend intakt, während sie still und leise das Schlagzeug löscht.
Der Gesang hat Stereobreite oder Hall
Alles, was die linke und die rechte Version der Stimme unterschiedlich macht, macht die Auslöschung unvollständig. Ein Stereohall oder eine gedoppelte Aufnahme genügt, und beides ist bei einem modernen Lead-Gesang Standard — deshalb zählt der 30-Sekunden-Test unten mehr als jede Einstellung.
Die Quelle ist eine verlustbehaftete Datei mit niedriger Bitrate
Joint-Stereo-Kodierung bei niedrigen Bitraten kann das Verhältnis zwischen den Kanälen so weit verändern, dass sich die beiden Seiten nicht mehr sauber auslöschen. Beginne mit der Datei in der höchsten Qualität, die du hast.
Ein 30-Sekunden-Test, bevor du dich festlegst
Nutze den Mechanismus selbst als Diagnose. Mach die Schritte 1–4 von Methode 2 — teilen, eine Seite invertieren, beide auf Mitte, abspielen — und hör hin:
- Der Gesang verschwindet sauber. Auslöschung funktioniert bei dieser Spur. Mach es dann richtig mit Methode 1, damit du den Bass behältst.
- Du hörst einen halligen Gesangsgeist. Es wird nicht funktionieren. Die trockene Stimme hat sich ausgelöscht, die nasse Fahne nicht, und keine Einstellung behebt das.
- Der Gesang ist noch deutlich da. Er ist nicht mittig. Auslöschung ist das falsche Werkzeug.
- Fast alles verschwindet. Die Datei ist faktisch mono.
Dreißig Sekunden Hinhören sparen eine Stunde Herumschrauben an Strength.
Was man nimmt, wenn Auslöschung nicht reicht
Die Grenze ist strukturell, kein Einstellungsproblem. Phasenauslöschung ist subtraktiv: Sie kann nur entfernen, was die beiden Kanäle gemeinsam haben, sie kann also nie eine Stimme freistellen, die sie geometrisch nicht orten kann.
KI-Quellentrennung funktioniert anders. Ein Modell, das auf vielen Stunden Musik trainiert wurde, lernt, wie eine Stimme klingt, und baut jeden Stem unabhängig neu auf. Weil es erkennt statt subtrahiert, kommt es mit Monodateien, außermittigen Gesängen und starkem Hall zurecht — genau den Fällen, in denen Audacity aufgibt. Der Preis ist Rechenzeit statt einer Menüoption.
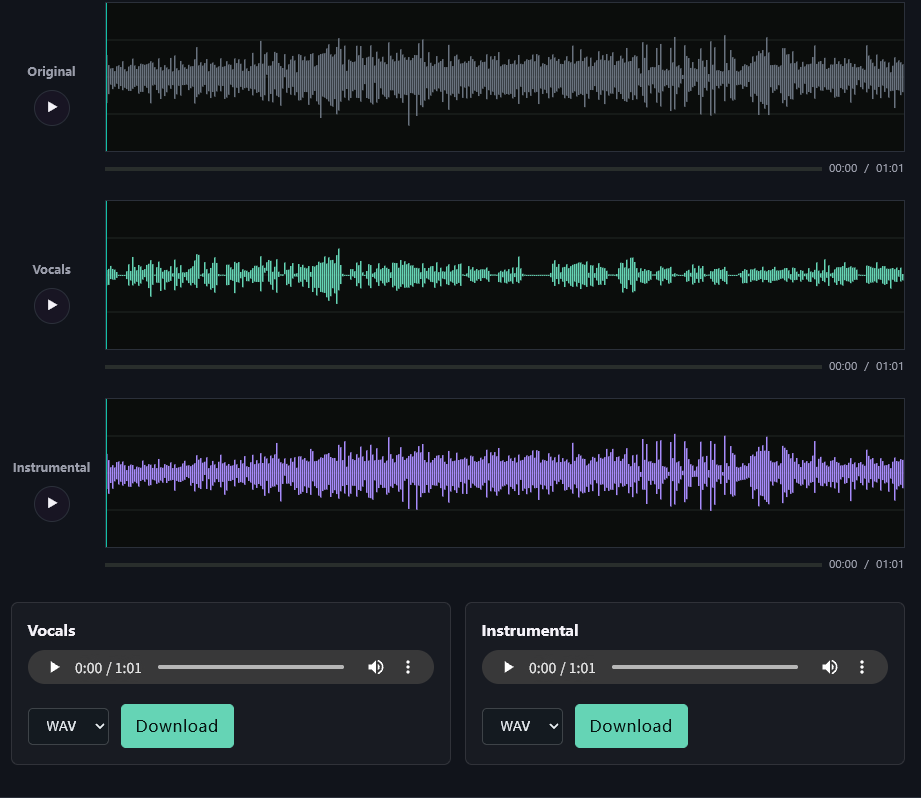
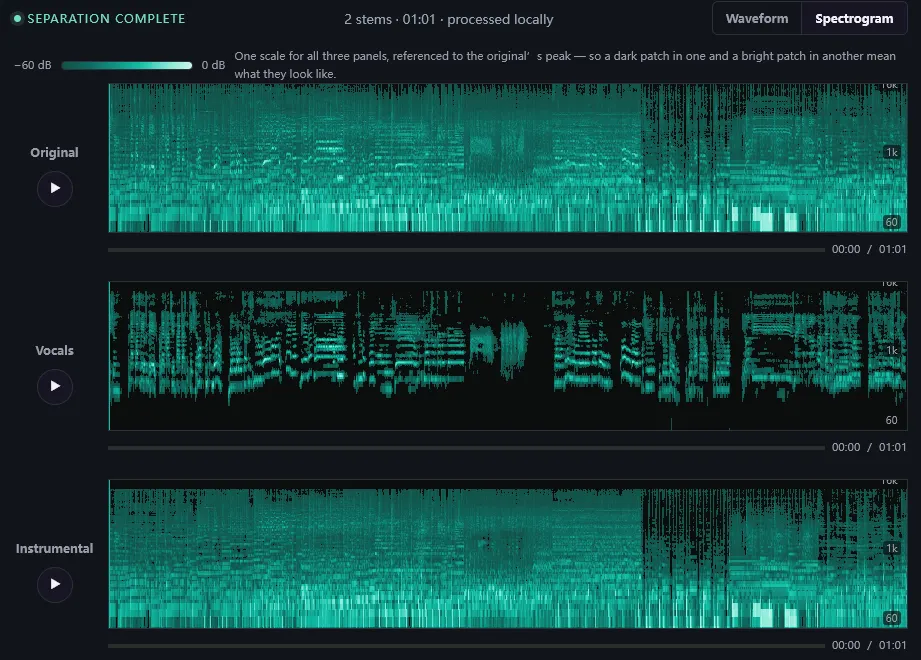
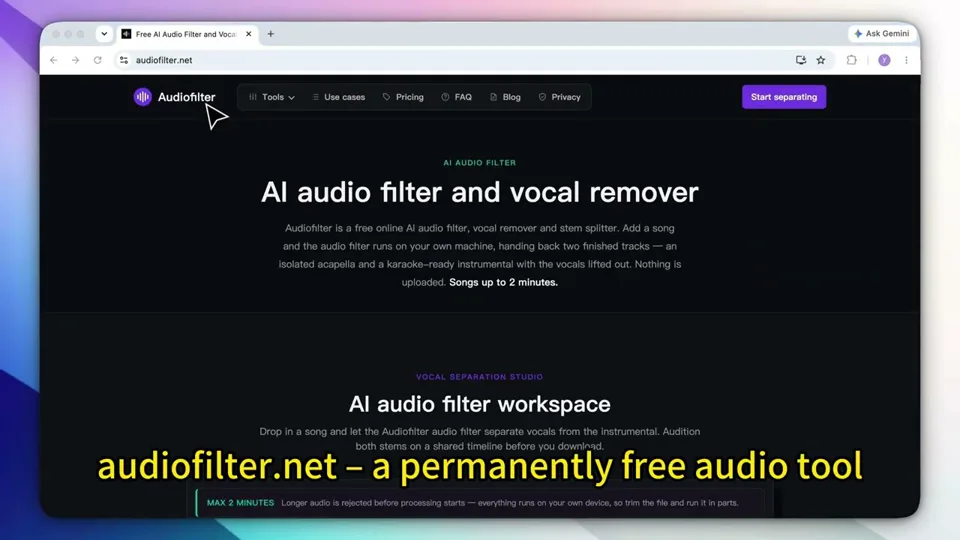
Der KI-Vocal-Remover von Audiofilter lässt ein Trennmodell im Browser-Tab laufen und gibt ein freigestelltes A cappella und ein karaokefertiges Instrumental zurück. Kein Konto, und nichts wird hochgeladen — die Verarbeitung passiert auf deinem eigenen Rechner, die Datei verlässt ihn also nie. Du kannst den Netzwerk-Tab beobachten und es selbst sehen.
Er nimmt Spuren bis zu fünf Minuten, was eine Grenze der Arbeit in einem Browser-Tab ist und keine Bezahlschranke. Für einen ganzen Song markiere den Abschnitt, den du brauchst, in Audacity und exportiere nur den mit File → Export Audio, dann füttere ihn hier ein.
Häufig gestellte Fragen
Hat Audacity einen KI-Vocal-Remover?
Nein. Vocal Reduction and Isolation ist Phasenauslöschung: Es subtrahiert, was im linken und im rechten Kanal identisch ist. Es hat kein Modell davon, was eine Stimme ist, deshalb kann es keinen Gesang trennen, der nicht mittig liegt, und deshalb nimmt es Kick und Bass mit.
Warum klingt mein Instrumental nach dem Entfernen des Gesangs dünn?
Weil der Lead-Gesang nicht das Einzige ist, das in die Mitte gepannt ist. Kick, Bass und Snare sitzen meist auch dort, und Bass ist unterhalb von etwa 120 Hz oft absichtlich mono. Die Mitte auszulöschen entfernt sie zusammen mit der Stimme. Low Cut for Vocals auf etwa 120 Hz anzuheben schont den Bassbereich, um den Preis, dass einige tiefe Mitten des Gesangs zurückbleiben.
Kann ich in Audacity Gesang aus einer Monodatei entfernen?
Nein. Phasenauslöschung braucht zwei Kanäle, die sich unterscheiden. Eine Monodatei hat nichts, wogegen subtrahiert werden könnte, es gibt also keine Mitte zu entfernen. Audacity zeigt eine Wellenform-Spur für eine Monospur und zwei für eine Stereospur, das ist der schnellste Weg, das zu prüfen.
Welche Strength-Einstellung soll ich nehmen?
Beginne bei 1.0 und hör auf den Tausch. Höhere Werte löschen mehr vom Gesang aus, aber auch mehr von allem anderen in der Mitte, das Instrumental verliert also Druck. Niedrigere Werte lassen das Schlagzeug intakt, aber den Gesang hörbar. Es gibt keine Einstellung, die nur die Stimme entfernt, weil der Effekt den Unterschied nicht kennt.
Gibt es einen kostenlosen Weg, Gesang zu entfernen, der mit Hall zurechtkommt?
Ja, aber nicht über Auslöschung. KI-Quellentrennung ist darauf trainiert, eine Stimme zu erkennen, sie funktioniert also bei Monodateien, außermittigen Gesängen und hallreichen Mischungen, und sie baut jeden Stem neu auf, statt einen vom anderen abzuziehen. Audiofilter lässt ein Trennmodell im Browser laufen, für Spuren bis zu fünf Minuten, ohne dass etwas hochgeladen wird.
Eher eine Aufnahme säubern als einen Song?
Rauschentfernung öffnen → Text-zu-Sprache öffnen →