RECORRIDO
Tres herramientas de audio en una pestaña del navegador
Un eliminador de voz, un reductor de ruido y una voz sintética, todos en tu propia máquina y sin subir nada. Aquí está el recorrido, lo que cada herramienta tiene que descargar antes de arrancar, y cómo comprobar tú mismo lo de «sin subidas» en unos diez segundos.
El recorrido
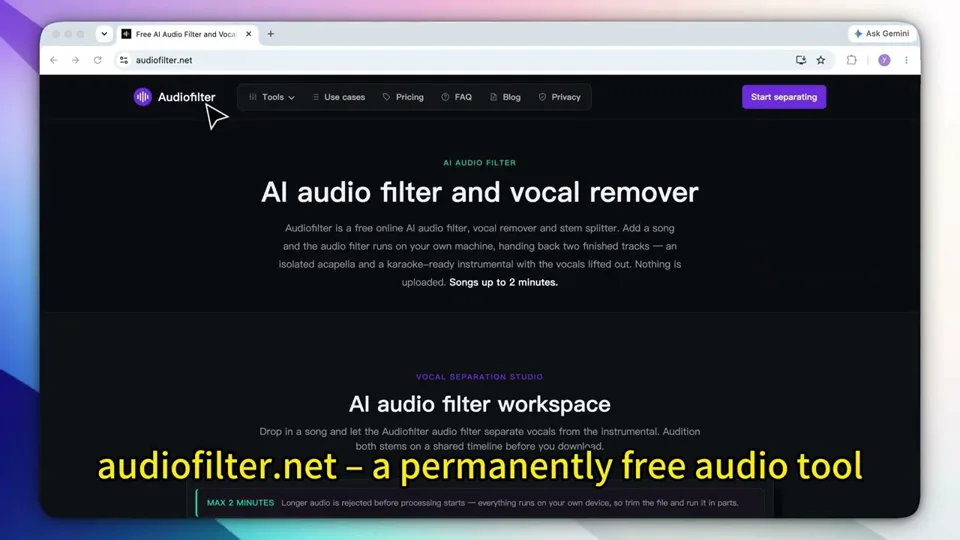
El vídeo ejecuta las tres herramientas de principio a fin: una canción separada en acapela e instrumental, una grabación hablada con la sala retirada de detrás de la voz, y una línea de texto escrita leída en alto. Una pasada, una máquina — y de eso se trata, porque esa máquina es la tuya y no la nuestra.
La parte que una grabación de pantalla no puede demostrar
Un vídeo de una herramienta funcionando es un vídeo de una herramienta funcionando. No puede enseñarte adónde fue el archivo, y esa es justamente la afirmación sobre la que merece la pena ser escéptico — todas las webs de audio gratuitas dicen algo tranquilizador sobre privacidad, y la mayoría sigue poniendo tu grabación en un servidor primero.
Esta se puede comprobar desde tu lado, sin fiarte de la palabra de nadie:
- Abre cualquiera de las tres herramientas y pulsa
F12(⌥⌘Ien un Mac), y luego elige el panel Red . - Marca Desactivar caché, para que la descarga del modelo aparezca en vez de salir del disco.
- Suelta tu archivo y déjalo llegar hasta el final.
- Lee la lista. Cada petición será un
GET, y todas ellas serán de un modelo o un script de este sitio.
Lo que buscas es lo que falta: ningún POST, ninguna petición con tu audio en el cuerpo, ningún progreso de subida en absoluto. El tráfico va en un solo sentido. El modelo se trae a donde ya está tu archivo, en lugar de enviar tu archivo a donde vive el modelo, y ese orden es toda la diferencia de arquitectura — no es una política de retención que pueda cambiar discretamente el próximo trimestre.
Desenchufa el cable de red una vez el modelo esté en caché y las herramientas siguen funcionando. Es el mismo hecho visto desde el otro extremo.
Lo que eso te cuesta
Ejecutar los modelos en local no es gratis — se factura de otra manera. En lugar de nuestro tiempo de servidor, gastas una descarga en la primera visita y tu propio procesador mientras dura el trabajo:
| Herramienta | Descarga de la primera visita | Límite |
|---|---|---|
| Eliminador de voz | Unos 52 MB — un motor de 12 MB más dos archivos de modelo de 20 MB, uno por stem | 5 minutos, 300 MB |
| Reductor de ruido | Unos 16 MB | 5 minutos, 300 MB |
| Texto a voz | Unos 64 MB por la red | 500 caracteres por generación |
Cada descarga ocurre una vez por herramienta y luego queda en la caché del navegador, así que una segunda visita arranca de inmediato y no necesita conexión. Los topes de duración existen por la misma razón que las descargas: una pista estéreo de cinco minutos desplegada a coma flotante ya es un objeto grande para sostenerlo en una sola pestaña, y una canción entera acabaría con la sesión en vez de esperar detrás de un muro de pago. Recorta primero el fragmento que quieras en cualquier editor y méte ese.
Conseguir que el modelo de texto a voz cupiera en un alojamiento estático resultó ser la mitad difícil del proyecto. Esa historia — un muro de 25 MiB por archivo, el aislamiento cross-origin, y un alojamiento que responde lo contrario de la verdad cuando le preguntas por la compresión — está contada aparte.
Las cifras de primera visita de arriba son megabytes de verdad, y un móvil con datos los va a notar. El reductor de ruido es el ligero, unos 16 MB. Texto a voz es el que conviene dejar para el wifi.
Separar una canción en dos stems
El eliminador de voz toma una mezcla y devuelve dos archivos: la voz aislada y el instrumental que queda. Lo hace por reconocimiento y no por sustracción, y esa distinción decide si funcionará en tu pista.
El método gratuito de siempre — el que viene en Audacity — es la cancelación de fase. Resta lo que los canales izquierdo y derecho tienen en común, suponiendo que la voz principal está centrada. A veces lo está. El bombo, el bajo y la caja suelen estarlo también, y el bajo a menudo se suma a mono por debajo de unos 120 Hz a propósito, así que se van con ella. En un archivo mono no hay nada contra lo que restar, y en una voz empapada en reverberación estéreo la reverberación sobrevive mientras desaparece la voz seca, lo que suena peor que no tocar nada. Escribimos sobre cómo hacerlo en Audacity y cuándo no funciona, con una prueba de 30 segundos para tu propio archivo.
Un modelo de separación ha sido entrenado con el aspecto que tiene una voz cantada a lo largo del tiempo y la frecuencia, así que reconstruye cada parte en vez de cancelar una contra otra. Por eso se apaña con grabaciones mono, voces descentradas y mucha reverberación, y por eso el instrumental conserva sus graves. Lo que no puede hacer es inventar detalle que nunca estuvo en la mezcla: donde la voz y una guitarra ocupan la misma banda estrecha en el mismo instante, hay que asignar algo a una de las dos, y ese juicio es exactamente lo que son los artefactos de separación.
Quitarle la sala a una grabación
El reductor de ruido es para voz, no para música. Mira la grabación en tramas cortas, estima para cada banda de frecuencia cuánto es voz y cuánto es sala, y aplica una ganancia a cada banda en consecuencia. El ruido estable y repetitivo — zumbido de ventilador, aire acondicionado, zumbido de red, siseo de micro — es lo que esta clase de modelo lee con más fiabilidad, porque su patrón se queda quieto mientras el habla no para de moverse.
El control que merece la pena entender es Ajuste fino, que fija un límite de atenuación en decibelios: un techo a cuánto se le permite quitar al modelo. Existe porque el mal resultado de una reducción de ruido no es el siseo que sobra, es una voz masticada hasta volverse acuosa y metálica. Poner tope a la reducción mantiene la voz intacta y deja algo de ruido, y ese suele ser el mejor intercambio para cualquier cosa que una persona tenga que escuchar durante media hora.
Hay una grabación de sala de nueve segundos en la página del reductor de ruido entre cuyo antes y después puedes alternar mientras suena. Entre frases — veintisiete huecos en nueve segundos, que es donde el ruido se oye más fácilmente — el suelo baja unos 17 dB. El habla en sí vuelve medio decibelio más baja de lo que entró. Ese segundo número es el que hay que comprobar en cualquier herramienta de ruido que pruebes, incluida esta: bajar toda la grabación siempre hará que un suelo de ruido se vea mejor, y medio decibelio no es eso.
Lo que no arregla es la reverberación. El eco es una copia de la voz y no algo que esté detrás de ella, así que no hay nada que el modelo pueda separar. Eso se soluciona acercando el micrófono, no después.
Leer en alto un texto escrito
La tercera herramienta va en el otro sentido: texto dentro, audio fuera. Hay 19 voces repartidas en 14 familias de acentos, y un límite de 500 caracteres por generación — unas 80 palabras, o cerca de 30 segundos de habla. Eso es una línea de narración o un pie de vídeo, que es la forma que de verdad necesita la mayoría, y es más fácil editar un guion línea a línea que volver a cortar un único archivo largo.
También clona una voz a partir de una muestra corta, y la muestra obedece la misma regla que todo lo demás aquí: se lee en la pestaña y no se envía a ningún sitio. Grábala en un sitio silencioso. Un clon reproduce la sala y la entonación junto con el timbre, así que una muestra con un ventilador de fondo produce una voz con un ventilador dentro.
Dónde un navegador es el sitio equivocado para esto
- Un álbum entero. Cinco minutos por pasada cubren la mayoría de canciones sueltas, pero cuarenta de ellas siguen siendo cuarenta pasadas. El trabajo por lotes pertenece a una máquina que puedas dejar funcionando.
- Cuatro stems o más. El separador divide la voz del resto. Separar batería, bajo y otras partes requiere otro modelo y más cómputo del que se le debería pedir a una pestaña.
- Una API. No hay ningún punto al que llamar, por construcción — no hay ningún servidor haciendo el trabajo.
- Una conexión medida en el móvil. La primera descarga es real, y texto a voz es la pesada.
- Control fino de la prosodia. Sin SSML, sin editor de fonemas, sin tono por palabra. Diriges la lectura reescribiendo el texto.
Preguntas frecuentes
¿Estas herramientas de audio suben mi archivo?
No. Cada herramienta descarga un modelo a la pestaña del navegador y lo ejecuta ahí, así que el audio se queda en tu propia máquina. No tienes que creerlo sin más: abre el panel de red del navegador antes de procesar nada y mira qué ocurre. Todas las peticiones son descargas de audiofilter.net — no hay ninguna subida que lleve tu archivo.
¿Cómo de grande es la primera descarga, y ocurre cada vez?
Unos 52 MB para el eliminador de voz, 16 MB para el reductor de ruido y 64 MB para texto a voz. Ocurre una vez por herramienta: el navegador guarda el modelo en caché, así que las visitas siguientes arrancan de inmediato y funcionan con la conexión apagada.
¿Por qué hay un límite de cinco minutos en las herramientas de audio?
Porque la separación y la limpieza se ejecutan en tu propio procesador y dentro de la memoria de una sola pestaña. Una canción entera agotaría la pestaña en vez de esperar detrás de un muro de pago. Recorta el fragmento que necesitas en cualquier editor y procesa eso.
¿Necesito instalar algo para usarlas?
No. No hay plugin, ni extensión, ni cuenta. Una versión reciente de Chrome, Edge, Firefox o Safari cubre el eliminador de voz y el reductor de ruido. Texto a voz le pide más al navegador y no funciona en todos los webview móviles.
¿Qué herramienta uso para una entrevista grabada?
El reductor de ruido. El eliminador de voz está hecho para música — divide una mezcla en acapela e instrumental, que no es lo que necesita una grabación hablada. Para zumbido de ventilador, aire acondicionado o ruido de calle detrás de una voz, el reductor de ruido es el adecuado.
Abre la que te ha traído aquí:
Eliminador de voz → Reductor de ruido → Texto a voz →