DÉMONSTRATION
Trois outils audio dans un seul onglet de navigateur
Un suppresseur de voix, un réducteur de bruit et une voix de synthèse, tous sur votre propre machine, sans rien envoyer. Voici la démonstration, ce que chaque outil doit télécharger avant de démarrer, et comment vérifier vous-même l'absence d'envoi en une dizaine de secondes.
La démonstration
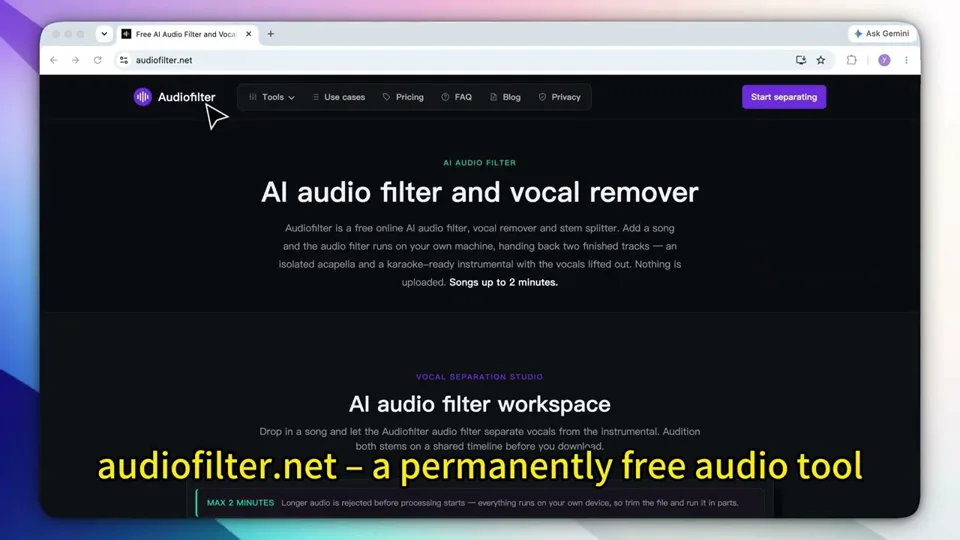
La vidéo fait tourner les trois outils du début à la fin : une chanson séparée en a cappella et instrumental, un enregistrement parlé dont la pièce a été retirée de derrière la voix, et une ligne de texte tapée lue à voix haute. Un passage, une machine — et c'est là tout l'intérêt, puisque cette machine est la vôtre et non la nôtre.
Ce qu'un enregistrement d'écran ne peut pas prouver
Une vidéo d'un outil qui fonctionne est une vidéo d'un outil qui fonctionne. Elle ne peut pas vous montrer où le fichier est allé, et c'est justement l'affirmation sur laquelle il vaut la peine d'être sceptique — tous les sites audio gratuits disent quelque chose de rassurant sur la confidentialité, et la plupart déposent quand même votre enregistrement sur un serveur d'abord.
Celle-ci est vérifiable de votre côté, sans croire personne sur parole :
- Ouvrez l'un des trois outils et appuyez sur
F12(⌥⌘Isur un Mac), puis choisissez le panneau Réseau . - Cochez Désactiver le cache, pour que le téléchargement du modèle apparaisse au lieu de venir du disque.
- Déposez votre fichier et laissez aller jusqu'au bout.
- Lisez la liste. Chaque requête sera un
GET, et chacune d'elles portera sur un modèle ou un script de ce site.
Ce que vous cherchez, c'est ce qui manque : aucun POST, aucune requête contenant votre audio dans son corps, aucune progression d'envoi du tout. Le trafic va dans un seul sens. Le modèle est amené là où votre fichier se trouve déjà, au lieu que votre fichier soit envoyé là où vit le modèle, et cet ordre est toute la différence d'architecture — ce n'est pas une politique de rétention qui pourrait changer discrètement au trimestre prochain.
Débranchez le câble réseau une fois le modèle en cache et les outils continuent de fonctionner. C'est le même fait vu de l'autre bout.
Ce que cela vous coûte
Faire tourner les modèles en local n'est pas gratuit — c'est facturé autrement. À la place de notre temps serveur, vous dépensez un téléchargement à la première visite et votre propre processeur pendant le travail :
| Outil | Téléchargement à la première visite | Limite |
|---|---|---|
| Suppresseur de voix | Environ 52 Mo — un moteur de 12 Mo plus deux fichiers de modèle de 20 Mo, un par stem | 5 minutes, 300 Mo |
| Réducteur de bruit | Environ 16 Mo | 5 minutes, 300 Mo |
| Synthèse vocale | Environ 64 Mo sur le réseau | 500 caractères par génération |
Chaque téléchargement a lieu une fois par outil puis est mis en cache par le navigateur, une deuxième visite démarre donc immédiatement et ne demande aucune connexion. Les plafonds de durée existent pour la même raison que les téléchargements : une piste stéréo de cinq minutes déployée en virgule flottante est déjà un gros objet à tenir dans un seul onglet, et une chanson entière mettrait fin à la session plutôt que d'attendre derrière un péage. Découpez d'abord le passage voulu dans n'importe quel éditeur et donnez-le à l'outil.
Faire tenir le modèle de synthèse vocale sur un hébergement statique s'est révélé être la moitié difficile du projet. Cette histoire — un mur de 25 Mio par fichier, l'isolation cross-origin, et un hébergeur qui annonce le contraire de la vérité quand on l'interroge sur la compression — est racontée à part.
Les chiffres de première visite ci-dessus sont de vrais mégaoctets, et un téléphone en données mobiles les sentira passer. Le réducteur de bruit est le léger, à environ 16 Mo. La synthèse vocale est celle à garder pour le wifi.
Séparer une chanson en deux stems
Le suppresseur de voix prend un mixage et rend deux fichiers : la voix isolée et l'instrumental qui reste. Il le fait par reconnaissance plutôt que par soustraction, et c'est cette distinction qui décide si cela marchera sur votre morceau.
La méthode gratuite bien connue — celle intégrée à Audacity — est l'annulation de phase. Elle soustrait ce que les canaux gauche et droit ont en commun, en supposant que la voix principale est centrée. Parfois elle l'est. La grosse caisse, la basse et la caisse claire le sont généralement aussi, et la basse est souvent sommée en mono sous environ 120 Hz à dessein, elles partent donc avec. Sur un fichier mono il n'y a rien contre quoi soustraire, et sur une voix noyée de réverbération stéréo, la réverbération survit tandis que la voix sèche disparaît, ce qui sonne plus mal que de ne rien faire. Nous avons détaillé comment le faire dans Audacity et quand cela ne marche pas, avec un test de 30 secondes pour votre propre fichier.
Un modèle de séparation a été entraîné à reconnaître à quoi ressemble une voix chantée à travers le temps et la fréquence, il reconstruit donc chaque partie au lieu d'annuler l'une contre l'autre. C'est pourquoi il s'accommode des enregistrements mono, des voix décentrées et des fortes réverbérations, et pourquoi l'instrumental garde son bas du spectre. Ce qu'il ne peut pas faire, c'est inventer un détail qui n'a jamais été dans le mixage : là où la voix et une guitare occupent la même bande étroite au même instant, il faut attribuer quelque chose à l'une des deux, et ce jugement, ce sont précisément les artefacts de séparation.
Retirer la pièce d'un enregistrement
Le réducteur de bruit est fait pour la parole, pas pour la musique. Il examine l'enregistrement par courtes trames, estime pour chaque bande de fréquence la part de voix et la part de pièce, et applique un gain à chaque bande en conséquence. Les bruits réguliers et répétitifs — bourdonnement de ventilateur, climatisation, ronflement secteur, souffle de micro — sont ceux que cette classe de modèle lit le plus sûrement, parce que leur motif reste immobile alors que la parole, elle, bouge sans cesse.
Le réglage qu'il vaut la peine de comprendre est Ajustement fin, qui fixe une limite d'atténuation en décibels : un plafond sur ce que le modèle a le droit de retirer. Il existe parce que le mauvais résultat d'une réduction de bruit n'est pas un reste de souffle, c'est une voix mâchée jusqu'à devenir aqueuse et métallique. Plafonner la réduction garde la voix intacte et laisse un peu de bruit, et c'est généralement le meilleur compromis pour tout ce qu'une personne doit écouter pendant une demi-heure.
Il y a un enregistrement de pièce de neuf secondes sur la page du réducteur de bruit entre l'avant et l'après duquel vous pouvez basculer pendant la lecture. Entre les phrases — vingt-sept silences en neuf secondes, et c'est là que le bruit s'entend le mieux — le plancher descend d'environ 17 dB. La parole elle-même revient un demi-décibel plus bas qu'elle n'est entrée. Ce second chiffre est celui à vérifier sur n'importe quel outil de débruitage, y compris celui-ci : baisser tout l'enregistrement fera toujours paraître un plancher de bruit meilleur, et un demi-décibel n'est pas cela.
Ce qu'il ne corrige pas, c'est la réverbération. Un écho est une copie de la voix et non quelque chose posé derrière elle, il n'y a donc rien à séparer pour le modèle. Celle-là se règle en rapprochant le micro, pas après coup.
Lire à voix haute un texte tapé
Le troisième outil va dans l'autre sens : du texte en entrée, de l'audio en sortie. Il y a 19 voix réparties sur 14 familles d'accents, et une limite de 500 caractères par génération — environ 80 mots, ou à peu près 30 secondes de parole. C'est une ligne de narration ou une légende, soit la forme dont la plupart des gens ont réellement besoin, et il est plus facile de modifier un script ligne par ligne que de recouper un seul long fichier.
Il clone aussi une voix à partir d'un court échantillon, et l'échantillon obéit à la même règle que tout le reste ici : il est lu dans l'onglet et n'est envoyé nulle part. Enregistrez-le dans un endroit calme. Un clone reproduit la pièce et le débit en même temps que le timbre, un échantillon avec un ventilateur en fond produit donc une voix avec un ventilateur dedans.
Là où un navigateur est le mauvais endroit pour ça
- Un album entier. Cinq minutes par passage couvrent la plupart des chansons isolées, mais quarante d'entre elles restent quarante passages. Le travail par lots appartient à une machine qu'on peut laisser tourner.
- Quatre stems ou plus. Le séparateur sépare la voix de tout le reste. Séparer la batterie, la basse et d'autres parties demande un autre modèle et plus de calcul qu'on ne devrait en demander à un onglet.
- Une API. Il n'y a aucun point d'accès à appeler, par construction — il n'y a pas de serveur qui fasse le travail.
- Une connexion à la consommation sur un téléphone. Le premier téléchargement est bien réel, et la synthèse vocale est le lourd.
- Le contrôle fin de la prosodie. Pas de SSML, pas d'éditeur de phonèmes, pas de hauteur par mot. Vous orientez la lecture en réécrivant le texte.
Questions fréquentes
Ces outils audio envoient-ils mon fichier ?
Non. Chaque outil télécharge un modèle dans l'onglet et l'y exécute, l'audio reste donc sur votre propre machine. Vous n'êtes pas obligé de nous croire : ouvrez le panneau réseau du navigateur avant de traiter quoi que ce soit et regardez ce qui se passe. Les requêtes sont toutes des téléchargements depuis audiofilter.net — il n'y a aucun envoi transportant votre fichier.
Quelle est la taille du premier téléchargement, et a-t-il lieu à chaque fois ?
Environ 52 Mo pour le suppresseur de voix, 16 Mo pour le réducteur de bruit et 64 Mo pour la synthèse vocale. Cela arrive une fois par outil : le navigateur met le modèle en cache, les visites suivantes démarrent donc immédiatement et fonctionnent connexion coupée.
Pourquoi y a-t-il une limite de cinq minutes sur les outils audio ?
Parce que la séparation et le nettoyage tournent sur votre propre processeur et dans la mémoire d'un seul onglet. Une chanson entière épuiserait l'onglet plutôt que d'attendre derrière un péage. Découpez le passage voulu dans n'importe quel éditeur et traitez-le.
Dois-je installer quelque chose pour les utiliser ?
Non. Pas de plugin, pas d'extension, pas de compte. Une version récente de Chrome, Edge, Firefox ou Safari couvre le suppresseur de voix et le réducteur de bruit. La synthèse vocale demande davantage au navigateur et ne tourne pas dans toutes les webviews mobiles.
Quel outil utiliser pour une interview enregistrée ?
Le réducteur de bruit. Le suppresseur de voix est fait pour la musique — il sépare un mixage en a cappella et instrumental, ce dont un enregistrement parlé n'a pas besoin. Pour un bourdonnement de ventilateur, une climatisation ou du bruit de rue derrière une voix, c'est le réducteur de bruit qu'il faut.
Ouvrez celui pour lequel vous êtes venu :
Suppresseur de voix → Réducteur de bruit → Synthèse vocale →