ОБЗОР
Три аудиоинструмента в одной вкладке браузера
Удаление вокала, шумоподавление и синтез речи — все работает на вашем собственном компьютере, и ничего не загружается на сервер. Ниже — видеообзор, что каждому инструменту нужно скачать перед началом работы и как самостоятельно проверить, что файлы не загружаются, примерно за десять секунд.
Видеообзор
В видео все три инструмента показаны от начала до конца: песня разделяется на акапеллу и инструментал, из-за голоса на записи речи убирается шум комнаты, а строка набранного текста зачитывается вслух. Один проход, один компьютер — и в этом весь смысл, потому что этот компьютер ваш, а не наш.
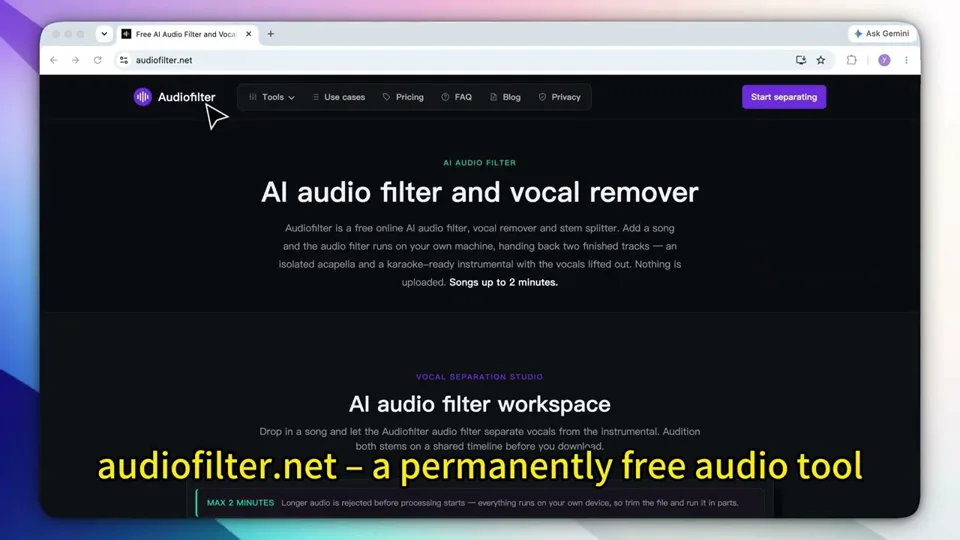
Чего не может доказать запись экрана
Видео работающего инструмента — это просто видео работающего инструмента. Оно не покажет, куда ушел файл, а это единственное утверждение, к которому стоит отнестись скептически, — каждый бесплатный аудиосайт говорит что-то успокаивающее о конфиденциальности, и большинство из них все равно сначала отправляют вашу запись на сервер.
Здесь это можно проверить самостоятельно, не веря никому на слово:
- Откройте любой из трех инструментов и нажмите
F12(⌥⌘Iна Mac), затем откройте панель Сеть (Network) в инструментах разработчика. - Поставьте галочку Отключить кеш (Disable cache), чтобы загрузка модели отобразилась, а не бралась с диска.
- Перетащите файл и дождитесь окончания обработки.
- Посмотрите список. Каждый запрос будет типа
GET, и каждый из них будет запрашивать модель или скрипт с этого сайта.
Искать нужно то, чего нет: ни POST, ни запроса с вашим аудио в теле, ни малейшего признака отправки файла. Трафик идет в одну сторону. Модель доставляется туда, где уже лежит ваш файл, а не ваш файл отправляется туда, где живет модель, и именно этот порядок составляет всю архитектурную разницу — это не политика хранения данных, которую могут тихо поменять в следующем квартале.
Выдерните сетевой кабель после того, как модель закешировалась, — и инструменты продолжат работать. Это тот же факт, только с другой стороны.
Чего это вам стоит
Локальный запуск моделей не бесплатен — просто платите вы иначе. Вместо нашего серверного времени вы тратите трафик на загрузку при первом визите и мощность своего процессора во время работы:
| Инструмент | Загрузка при первом визите | Ограничение |
|---|---|---|
| Удаление вокала | Около 52 МБ — среда выполнения на 12 МБ плюс два файла модели по 20 МБ, по одному на дорожку | 5 минут, 300 МБ |
| Шумоподавление | Около 16 МБ | 5 минут, 300 МБ |
| Озвучка текста | Около 64 МБ по сети | 500 символов за одну генерацию |
Каждая загрузка происходит один раз для каждого инструмента, после чего браузер ее кеширует, так что при повторном визите все запускается сразу и без подключения к сети. Ограничения по длительности существуют по той же причине, что и загрузки: пятиминутный стереотрек, развернутый в числа с плавающей точкой, — это уже крупный объект для одной вкладки браузера, а целая песня просто обрушила бы сессию, а не встала бы в очередь за платным доступом. Сначала вырежьте нужный фрагмент в любом редакторе и обработайте его.
Разместить модель синтеза речи на статическом хостинге вообще оказалось самой трудной половиной проекта. Эта история — предел 25 МиБ на файл, cross-origin isolation и хостинг, который на вопрос о сжатии отвечает прямо противоположное правде, — описана отдельно.
Цифры для первого визита выше — это настоящие мегабайты, и телефон на мобильном интернете их почувствует. Шумоподавление — самое легкое, около 16 МБ. Озвучку текста лучше оставить для Wi-Fi.
Как разделить песню на две дорожки
Удаление вокала берет микс и возвращает два файла: отдельный вокал и оставшийся инструментал. Оно делает это за счет распознавания, а не вычитания, и именно это различие определяет, сработает ли оно на вашем треке.
Привычный бесплатный способ — тот, что встроен в Audacity, — это подавление в противофазе. Он вычитает все, что есть общего у левого и правого каналов, исходя из того, что основной вокал стоит по центру. Иногда так и есть. Но бочка, бас и малый барабан обычно тоже стоят по центру, а бас ниже примерно 120 Гц часто намеренно сводят в моно, поэтому они уходят вместе с голосом. В моно-файле вычитать не из чего, а если вокал утоплен в стереоревербе, реверберация остается, а сухой голос пропадает, и звучит это хуже, чем если бы вы ничего не трогали. Мы подробно описали, как это сделать в Audacity и когда это не сработает, включая 30-секундный тест для вашего собственного файла.
Модель разделения обучена тому, как певческий голос выглядит во времени и по частотам, поэтому она заново собирает каждую часть, а не гасит одну другой. Поэтому она справляется с моно-записями, вокалом не по центру и сильной реверберацией, а инструментал сохраняет низы. Чего она не может — так это придумать детали, которых в миксе никогда не было: там, где голос и гитара в один и тот же момент занимают одну узкую полосу, что-то придется отнести к одному из них, и именно такие решения и есть артефакты разделения.
Как убрать из записи звучание комнаты
Шумоподавление предназначено для речи, а не для музыки. Оно разбирает запись короткими кадрами, оценивает для каждой частотной полосы, какая доля в ней приходится на голос, а какая на комнату, и соответственно применяет к каждой полосе усиление. Ровный, повторяющийся шум — гул вентилятора, кондиционер, сетевой фон, шипение микрофона — такие модели распознают надежнее всего, потому что его рисунок стоит на месте, а речь постоянно меняется.
Параметр, в котором стоит разобраться, — Fine-tune, который задает предел подавления в децибелах: потолок того, сколько модели разрешено убрать. Он нужен потому, что плохой исход шумоподавления — это не остаточное шипение, а голос, изжеванный до чего-то водянистого и металлического. Ограничение подавления сохраняет голос целым и оставляет немного шума, и для всего, что человеку придется слушать полчаса, это обычно лучший компромисс.
На странице шумоподавления есть девятисекундная запись в комнате, которую можно переключать между «до» и «после» прямо во время воспроизведения. Между фразами — двадцать семь пауз за девять секунд, где шум слышнее всего, — уровень шума падает примерно на 17 дБ. Сама речь выходит на полдецибела тише, чем была. Именно это второе число стоит проверять у любого инструмента шумоподавления, который вы пробуете, включая этот: если просто сделать всю запись тише, уровень шума всегда будет выглядеть лучше, а полдецибела — это совсем не то.
А вот реверберацию оно не исправит. Эхо — это копия голоса, а не что-то, что звучит за ним, так что модели нечего отделять. Эта проблема решается тем, что вы ставите микрофон ближе, а не последующей обработкой.
Чтение набранного текста вслух
Третий инструмент работает в обратную сторону: на входе текст, на выходе аудио. Доступно 19 голосов из 14 групп акцентов и ограничение в 500 символов за генерацию — примерно 80 слов, или около 30 секунд речи. Это одна реплика закадрового текста или подпись — именно то, что большинству людей на самом деле нужно, и сценарий проще править по одной строке, чем перерезать один длинный файл.
Он также умеет клонировать голос по короткому образцу, и образец подчиняется тому же правилу, что и все остальное здесь: он читается во вкладке и никуда не отправляется. Записывайте его в тихом месте. Клон воспроизводит не только тембр, но и комнату, и манеру подачи, так что из образца с вентилятором на фоне получится голос с вентилятором внутри.
Когда браузер — неподходящее место для этой задачи
- Целый альбом. Пяти минут за проход хватает на большинство отдельных песен, но сорок песен — это все равно сорок проходов. Пакетной обработке место на компьютере, который можно оставить работать.
- Четыре дорожки и больше. Сепаратор отделяет вокал от всего остального. Для отдельных барабанов, баса и прочих партий нужна другая модель и больше вычислений, чем разумно требовать от вкладки.
- API. Эндпоинта для вызова нет, и так задумано — работу не выполняет никакой сервер.
- Лимитный мобильный интернет на телефоне. Первая загрузка весит немало, и тяжелее всего — озвучка текста.
- Тонкое управление интонацией. Нет SSML, нет редактора фонем, нет настройки высоты тона для отдельных слов. Управлять прочтением можно, только переписывая текст.
Часто задаваемые вопросы
Эти аудиоинструменты загружают мой файл на сервер?
Нет. Каждый инструмент скачивает модель во вкладку браузера и запускает ее там, поэтому аудио остается на вашем компьютере. Не обязательно верить на слово: откройте сетевую панель браузера до обработки и посмотрите, что происходит. Все запросы — это загрузки с audiofilter.net — никакой отправки вашего файла нет.
Насколько велика первая загрузка и происходит ли она каждый раз?
Около 52 МБ для удаления вокала, 16 МБ для шумоподавления и 64 МБ для озвучки текста. Загрузка происходит один раз для каждого инструмента: браузер кеширует модель, поэтому при следующих визитах все запускается сразу и работает без подключения к сети.
Почему у аудиоинструментов ограничение в пять минут?
Потому что разделение и очистка выполняются на вашем процессоре и в памяти одной вкладки браузера. Целая песня исчерпала бы ресурсы вкладки, а не встала бы в очередь за платным доступом. Вырежьте нужный фрагмент в любом редакторе и обработайте его.
Нужно ли что-то устанавливать?
Нет. Ни плагина, ни расширения, ни регистрации. Для удаления вокала и шумоподавления достаточно свежей версии Chrome, Edge, Firefox или Safari. Озвучка текста требует от браузера большего и работает не в каждом мобильном webview.
Какой инструмент выбрать для записанного интервью?
Шумоподавление. Удаление вокала создано для музыки — оно делит микс на акапеллу и инструментал, а для записи речи это не нужно. Против гула вентилятора, кондиционера или уличного шума за голосом подходит именно шумоподавление.
Откройте тот, ради которого пришли:
Удаление вокала → Шумоподавление → Озвучка текста →